À court d’arguments, l’ami ?
Fais-moi signe si tu as toujours besoin d’aide pour migrer le forum, au fait…
Considérez la remarque précédente comme un avertissement officiel. Cette attitude et ces propos ne sont pas tolérés ici.
Eh bien, j’ai tendu un rameau d’olivier et présenté mes excuses pour les attaques personnelles, et cela a été accueilli avec dérision. Voilà où on en est…
Même si je serais triste d’être exclu de ce forum (en fait, j’étais sur le point de proposer des corrections pour des inexactitudes sur les pages ASIC - CPCWiki, que j’ai repérées grâce à l’IA en écrivant mon core FPGA GX4000), j’accorde encore plus d’importance à la vérité. Je ne suis clairement pas un fin diplomate et je suis tout à fait disposé à calmer le jeu, mais je ne céderai rien sur les faits concernant un sujet que je connais plutôt bien. Si tu estimes que c’est un problème, je ne peux pas t’empêcher de faire ton travail d’admin…
Au fait, tu trouveras peut-être (ou non) que l’actualité du jour est pertinente par rapport au sujet :
Le noyau Linux supprime l’obligation de baliser les soumissions de code généré par l’IA.
Au cours des 10 derniers mois, nous avons pu suivre la progression constante du code généré par l’IA dans le noyau (avec plus de 20 % de l’ensemble des soumissions de code générées par l’IA, jusqu’à présent en octobre)… nous le savons grâce à la balise IA « Assisted-by » obligatoire dans le noyau.
Avec la suppression de cette obligation, nous ne pourrons plus suivre efficacement le niveau de développement par IA au sein de Linux.
Ce changement a été convenu (par la majorité des devs du noyau) lors du Linux Maintainers Summit, qui s’est tenu la semaine dernière à Prague.
Les raisons invoquées pour supprimer l’obligation de « déclaration d’IA » sont variées, mais se résument à ces trois arguments :
L’utilisation de l’IA pour coder le noyau Linux devient tellement répandue que le déclarer devient redondant. (Un développeur a comparé cela au fait de déclarer quel éditeur de texte on a utilisé.)
Les développeurs du noyau Linux estiment que la plupart des développeurs utilisant l’IA… ne respectent de toute façon pas la règle d’étiqueter leurs soumissions comme telles.
D’autres développeurs ont l’impression qu’il s’agit d’une « publicité gratuite » pour diverses plateformes d’IA.
Ce changement n’a pas encore été officiellement fusionné, mais (étant donné qu’il a déjà été approuvé et semble bénéficier du soutien des mainteneurs de premier plan de la Fondation Linux), cela devrait se faire sous peu.
Aucune moquerie ; et à vrai dire, tes propos qui ont suivi ce « rameau d’olivier » ont bien montré à quel point tu étais sincère. Au pire, tu peux toujours signaler un message offensant.
En parlant de rameaux d’olivier : j’imagine que tu n’y connais pas grand-chose, mais tendre un rameau d’olivier dans la Grèce antique gelait la violence immédiate, sans pour autant accorder l’immunité, pardonner un crime ou forcer une cité à accorder la citoyenneté. De plus, selon le droit coutumier (Dracon/Solon), en présenter un protégeait un meurtrier d’une vengeance immédiate, mais ne le mettait pas à l’abri d’une sanction judiciaire ultérieure.
En d’autres termes, dire « oups, désolé » ne vaut absolument rien quand on ne le pense pas et qu’on garde la même attitude.
Enfin, tu as l’air de croire qu’il faut être diplomate pour éviter d’être offensant ou de recourir aux insultes directes. Eh bien, j’ai une nouvelle pour toi…
PS : l’analogie avec le noyau Linux est ridicule. Ce n’est pas comme s’il existait un dépôt avec plusieurs noyaux qu’on pourrait tester et dont on voudrait savoir s’ils sont « vibe codés » ou non.
2 « J'aime »
reno08, pour ma part, je tiens simplement à m’excuser si l’un de mes propos t’a blessé.
1 « J'aime »
Pour info, je maintiens totalement l’affirmation selon laquelle l’IA, c’est comme avoir un développeur junior (voire une équipe de développeurs juniors) capable de travailler très, très vite. Et je ne pense pas que les efforts autour du noyau Linux y changent quoi que ce soit.
Un bon chef d’équipe, tenant fermement la barre, peut tirer énormément de travail vraiment utile, même de la part de développeurs très juniors. Cela demande d’être rigoureux, de surveiller attentivement ce qui est produit et de s’assurer que les erreurs ou le travail de mauvaise qualité soient repérés rapidement et refaits au besoin. Ce sont exactement les mêmes compétences requises pour tirer le meilleur parti de l’IA.
En revanche, si vous laissez simplement l’IA faire ce qu’elle veut sans lui donner rien de plus que des directives vagues, vous vous retrouverez avec une bouillie de code à peine fonctionnelle, incroyablement difficile à comprendre et qui ressemble davantage à des exemples mal copiés depuis Stack Overflow. Exactement comme une bande de juniors livrés à eux-mêmes.
Et si vous pensez que je suis anti-IA, je vous suggère alors de relire ce fil de discussion d’un peu plus près.
6 « J'aime »
Je rejoins tout à fait ce qu’a dit @AndyCadley, à 100 %.
1 « J'aime »
Intéressant… point de vue ?
1 « J'aime »
Pour être honnête, cela semble être une conséquence assez inévitable. Je ne suis d’ailleurs pas sûr que le fait d’être open source ou closed source ait encore une réelle importance. L’IA est devenue tellement douée pour désassembler le code et le retransformer en code source que la distinction s’estompe forcément.
Il sera intéressant de voir si cela finit devant les tribunaux, car tout le concept de réimplémentation en « salle blanche » (clean room) entre agents IA coordonnés a le potentiel d’automatiser le clonage massif de logiciels d’une manière encore jamais envisageable auparavant.
2 « J'aime »
Eh bien, le site mentionné ci-dessus relève plutôt du commentaire sarcastique que de quelque chose de sérieux, mais il tourne en dérision une réalité possible à laquelle nous devrions peut-être nous préparer. L’IA (et la « libéralisation maximale » qui l’accompagne) sonnera-t-elle le glas des logiciels open source, par exemple ?
2 « J'aime »
J’imagine que ce sera la même chose pour les productions CPC.
Et ces dernières semaines, avec toutes les sorties qui apparaissent, je ne sais souvent pas trop quoi en penser. Je vois beaucoup de PoC vraiment intéressants ou de jeux prometteurs qui sont clairement faits avec de l’IA — mais je les apprécie quand même ou je les trouve intéressants — et c’est généralement lié à un effort significatif investi par le développeur. Ce n’est pas nécessairement du code Z80 ou des graphismes faits à la main — mais une sorte de « soin » apporté à l’ensemble.
Et puis, il y a des productions qui sont « publiées », et dès l’instant où je les vois, les entends — et y joue, je suis agacé car il est évident qu’il s’agit juste de ce que l’IA a recraché, sans le moindre soin.
L’IA sera utilisée dans la grande majorité des sorties, donc coller une étiquette n’aidera probablement pas, puisque c’est la norme de toute façon.
Peut-être devrions-nous plutôt mettre en avant les productions réalisées sans son aide, par exemple avec un label « fait main » pour celles qui n’utilisent aucune assistance de l’IA, ou du moins aucune aide directe.
Et je pense qu’on devrait épingler les sorties faites avec un minimum de soin et d’effort — et aucune intention de corriger le tir. Celles-là méritent bien l’étiquette « soupe d’IA » (AI slop).
Ça me paraît assez évident. L’IA utilisée comme outil de dev, aucun problème. L’IA pour développer entièrement un jeu ou balancer du contenu à la pelle sur la machine, par contre, non.
L’IA est vraiment douée pour trier des trucs, faire des calculs et gérer les corvées ingrates. Il n’y a pas plus de raison de devoir déclarer ça que de déclarer qu’on a utilisé un utilitaire de conversion de sprites. C’est juste un outil de dev parmi d’autres.
Mais pour porter à la va-vite des jeux Master System sur la bécane ? Pour générer du code dont on n’a pas la moindre idée de comment il fonctionne ? Pour pondre un jeu sans jamais avoir touché à une seule ligne de code ?
Ma plus grande inquiétude, c’est que des sites comme CPC Power se retrouvent inondés de portages moisis plutôt que de projets dans lesquels les gens ont réellement mis du cœur à l’ouvrage.
Je pensais que les gens codaient sur ces machines justement parce que leur taf de dev au quotidien les éloignait beaucoup trop du hardware. Or, coder avec l’IA, c’est ce qu’il y a de plus éloigné du hardware possible.
7 « J'aime »
C’est exactement ce que je pense aussi — pour plus tard.
C’est une question de perception, pas de limites physiques strictes. Donc si et quand nous nous serons habitués à l’IA, nous pourrons inverser les choses.
1 « J'aime »
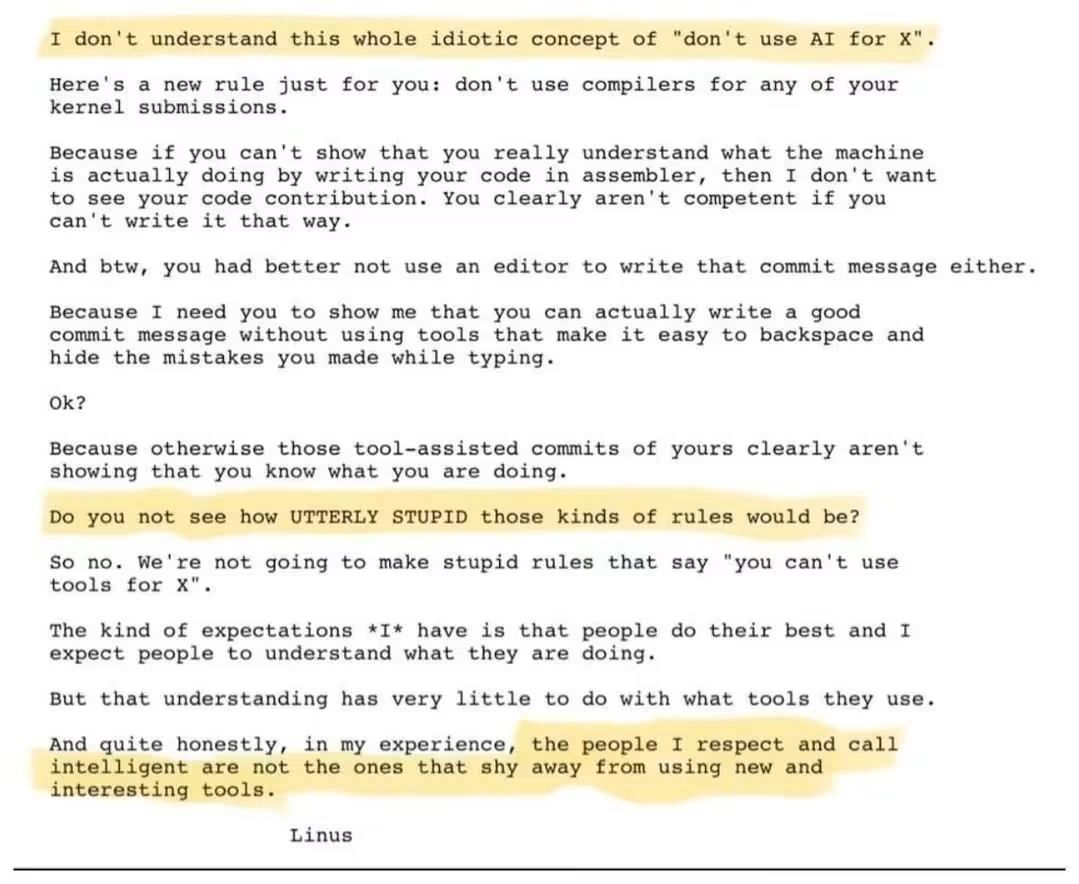
Même Lui ne peut pas toujours avoir raison
(et ce post de sa part est tout simplement idiot, passant volontairement à côté de la question et tombant dans le piège classique du sophisme de l’« ad absurdum »)
1 « J'aime »
Le pire, c’est que — de mon point de vue — il ne s’agit pas seulement de satire, mais aussi d’un modèle économique qui pourrait vraiment fonctionner. Les répercussions ne vont pas seulement nuire à l’open source, mais aussi au développement minutieux du code propriétaire. Au bout d’un moment, plus personne ne fournira d’effort invisible ou non rémunéré, et il ne restera plus que de la bouillie.
Je suis d’accord, ce post est (en grande partie) absurde. Donnez un éditeur de texte à quelqu’un qui n’y connaît rien, et il n’arrivera à rien. Donnez-lui un compilateur, et il n’arrivera toujours à rien. Donnez-lui un IDE doté d’une autocomplétion non basée sur l’IA, et il n’arrivera toujours à rien. Donnez-lui en revanche un agent IA, et il pourra produire des résultats qui semblent corrects à première vue, mais qui contiennent des erreurs et des portes dérobées dans l’une des parties les plus critiques pour la sécurité du logiciel.
L’IA aide probablement un expert, mais elle permet aussi à quelqu’un qui ne comprend pas grand-chose à la technologie sous-jacente de se faire passer pour un expert.
Pour être tout à fait juste, je tiens aussi à citer une phrase importante de ce post :
The kind of expectation I have is that people […] understand what they are doing.
Avoir des attentes, c’est bien, mais vérifier, ce serait mieux. L’IA complique tout cela.
2 « J'aime »
Tu es sûr que Linus a vraiment dit ce qui est sous-entendu ici ?
Linux s’adresse à des personnes compétentes, n’est-ce pas ? Donc, « donne à quelqu’un qui n’y connaît rien », ce n’est pas ce dont il parle.
Ne parle-t-il pas plutôt d’une autre situation ? « Donne à une personne compétente… » :
- un éditeur de texte → elle peut modifier du code ASM, ce qui est mieux que d’écrire sans pouvoir éditer
- un compilateur → elle peut écrire du code de haut niveau, bien plus productif que l’ASM
- un IDE → elle peut être plus productive qu’avec un simple éditeur + compilateur
- un agent IA → elle peut être plus productive, en déléguant les tâches fastidieuses à l’IA tout en gardant le contrôle (on apprend encore à le faire, et certaines personnes le font très mal)
L’idée de Linus n’est-elle pas plutôt que l’IA peut aider les programmeurs compétents à produire du meilleur code ?
Oui, et je vois deux problèmes d’ordre pratique :
- Un inconnu débarque et montre ce qu’il a fait. Auparavant, seule une personne un minimum compétente pouvait présenter un logiciel non trivial. Maintenant que l’IA permet à n’importe qui de présenter des réalisations, il est plus difficile de savoir si la personne savait vraiment ce qu’elle faisait.
- Relire du code est long et difficile. Maintenant que l’IA permet de générer facilement des tonnes de code, la capacité de relecture est devenue insuffisante, et il est plus dur de juger si le code est bon.
1 « J'aime »
Oui, je suis d’accord, c’est probablement ce qu’il voulait dire. J’imagine qu’il vit dans une bulle de personnes vraiment compétentes et qu’il n’a même pas pensé au fait que son argument englobe désormais aussi d’autres personnes, moins compétentes. La phrase citée (« les gens [doivent] comprendre ce qu’ils font ») est assez courte comparée aux exemples absurdes et élaborés.
J’ai souvent entendu cet argument. J’objecterais ceci : si programmer devient rébarbatif, c’est qu’il y a une faille dans le choix des algorithmes, des bibliothèques, de l’architecture ou de l’organisation. Concentrez-vous sur la cause profonde, pas sur les symptômes. Sinon, la dette technique (ou autre) s’accumule et le même problème réapparaîtra encore et encore. Malheureusement, bien trop souvent, la pression du temps fige et aggrave les problèmes.
Certains d’entre nous travaillent dans des environnements où ce n’est hélas pas possible. Et souvent, les causes profondes, eh bien, ce sont les gens (quelle surprise !)